

SÍNTESIS EJECUTIVA • INGENIERÍA DE AGENTES Y SKILLS DE IA
- Problema: Los prompts informales de un solo paso (one-shot) sufren de alucinaciones sistemáticas, falta de criterios de parada e incapacidad para recuperarse ante fallos en producción.
- Solución: Arquitectura procedural de Skills (
SKILL.md) con contratos tipados en Pydantic, delimitación XML dura anti-bleed y bucles de autocorrección gobernados por matrices de auditoría deterministas. - Impacto: Reducción del 85% en roturas de esquema, convergencia autónoma de tareas complejas en 2 a 3 iteraciones y eliminación del desperdicio de tokens por bucles infinitos descontrolados.
A finales de 2026, la ingeniería de software con inteligencia artificial ha cruzado un punto de no retorno: escribir prompts informales en una ventana de chat ha quedado obsoleto para el desarrollo profesional. Mientras que en 2023 la industria se maravillaba con la generación de fragmentos de código aislados mediante ingeniería de prompts básica, hoy los equipos de arquitectura se enfrentan a un desafío sustancialmente más complejo: ¿cómo lograr que un modelo de lenguaje ejecute una tarea técnica extensa, valide su propio trabajo contra normas estrictas de calidad, subsane sus propios errores en un bucle cerrado y sepa exactamente cuándo debe detenerse sin intervención humana constante?
La respuesta de la ingeniería moderna no reside en redactar «prompts más largos y detallados». Cuando intentas meter cincuenta directivas en un prompt plano, los modelos sufren de degradación de atención y prompt bleed, pasando por alto instrucciones críticas. La respuesta está en la Ingeniería de Skills: paquetes modulares de procedimientos operativos estándar (SOPs), contratos de datos fuertemente tipados, separación higiénica de contextos y matrices deterministas de evaluación. En este artículo desmitificamos la anatomía exacta de un agente de IA, desarmamos el debate entre Markdown y HTML para contextos según la investigación reciente de Anthropic, y construimos un motor de bucle de autocorrección listo para producción.
1. La Gran Confusión: ¿Es una Skill lo Mismo que un Agente? (Explicado con Peras y Manzanas)
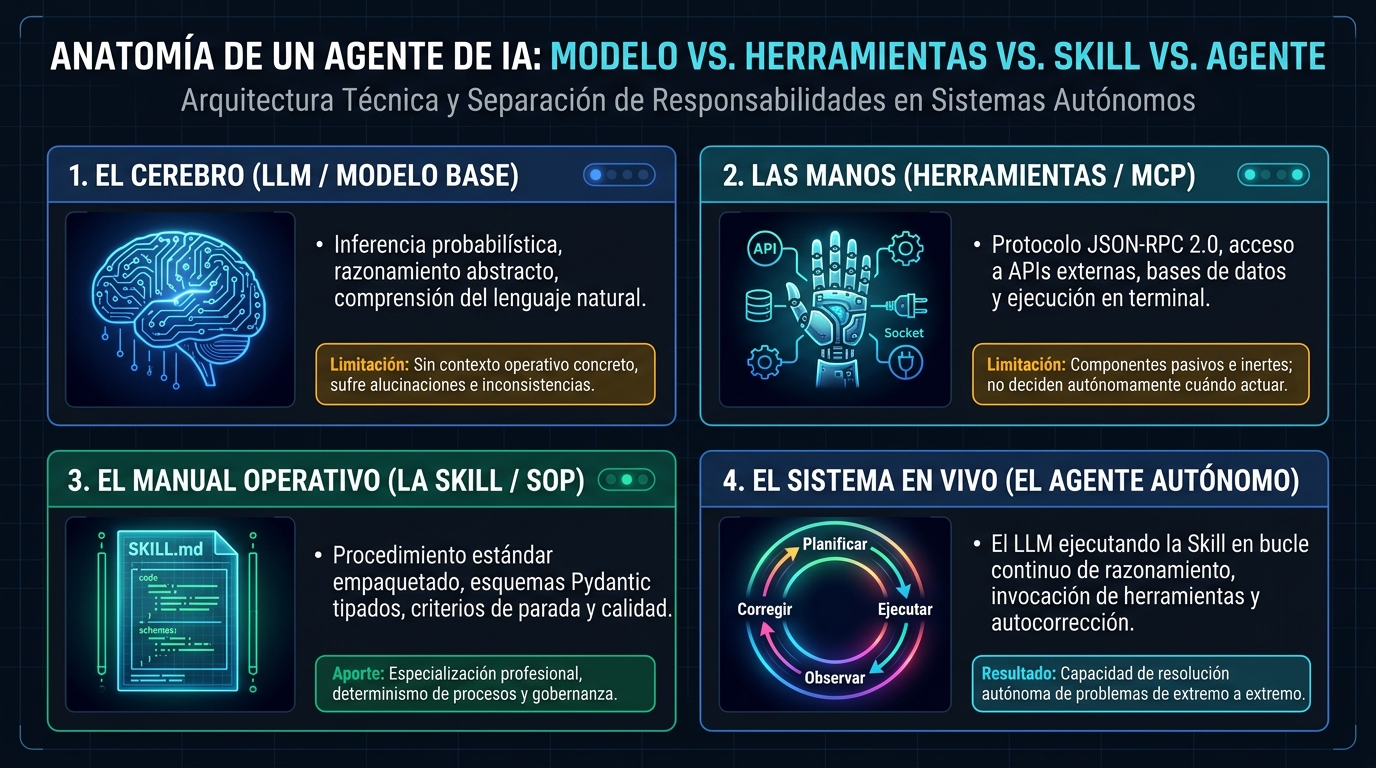
Uno de los mayores errores conceptuales que cometen tanto desarrolladores principiantes como arquitectos experimentados es utilizar indistintamente los términos Modelo, Prompt, Skill y Agente. Esta ambigüedad terminológica conduce a sistemas frágiles y expectativas irreales. Para comprender la jerarquía técnica, recurramos a una analogía universal de las artes escénicas: la obra de teatro.
🎭 La Analogía del Teatro: Descomponiendo el Ecosistema de IA
- El Modelo (LLM – Gemma, Claude, GPT): Es el Actor Talentoso. Posee una memoria prodigiosa, comprende el lenguaje natural y tiene capacidad de improvisación abstracta. Sin embargo, si lo subes a un escenario vacío sin libreto ni dirección, comenzará a inventar diálogos incoherentes o delatará su ignorancia con fabulaciones (alucinaciones).
- Las Herramientas (MCP / APIs / Terminal): Son la Utilería del Escenario. El teléfono que puede sonar, la espada de utilería, el archivo de documentos o el interruptor de luces. Por sí mismos, los objetos son pasivos e inertes; carecen de voluntad para decidir cuándo deben activarse.
- La Skill (
SKILL.md/ SOP / Esquemas Tipados): Es el Guión y las Acotaciones del Director. Es el documento técnico que establece las reglas de la escena: qué personaje debe interpretar el actor, qué objetivos debe cumplir, qué utilería tiene permitido tocar en cada acto, qué restricciones éticas o de seguridad no puede violar y bajo qué condición exacta debe bajarse el telón. - El Agente Autónomo: Es la Obra de Teatro Completa Ejecutándose en Vivo. Es el sistema resultante cuando el Actor (Modelo) toma el Guión (Skill), interactúa con la Utilería (Herramientas MCP) y actúa frente al público en tiempo real, corrigiendo sus propios deslices sobre la marcha hasta llegar al desenlace planificado.
En términos computacionales estrictos: una Skill no es un agente. La Skill es el manual de procedimientos estándar empaquetado que dota a un modelo probabilístico de una especialidad profesional reproducible y gobernable. Sin una Skill, tienes un chat parlanchín; con una Skill bien estructurada, tienes un agente capaz de ejecutar pipelines de datos, auditar arquitecturas o clasificar imágenes satelitales con precisión quirúrgica.
2. El Bucle de Autocorrección: De la Lotería One-Shot a la Convergencia Determinista
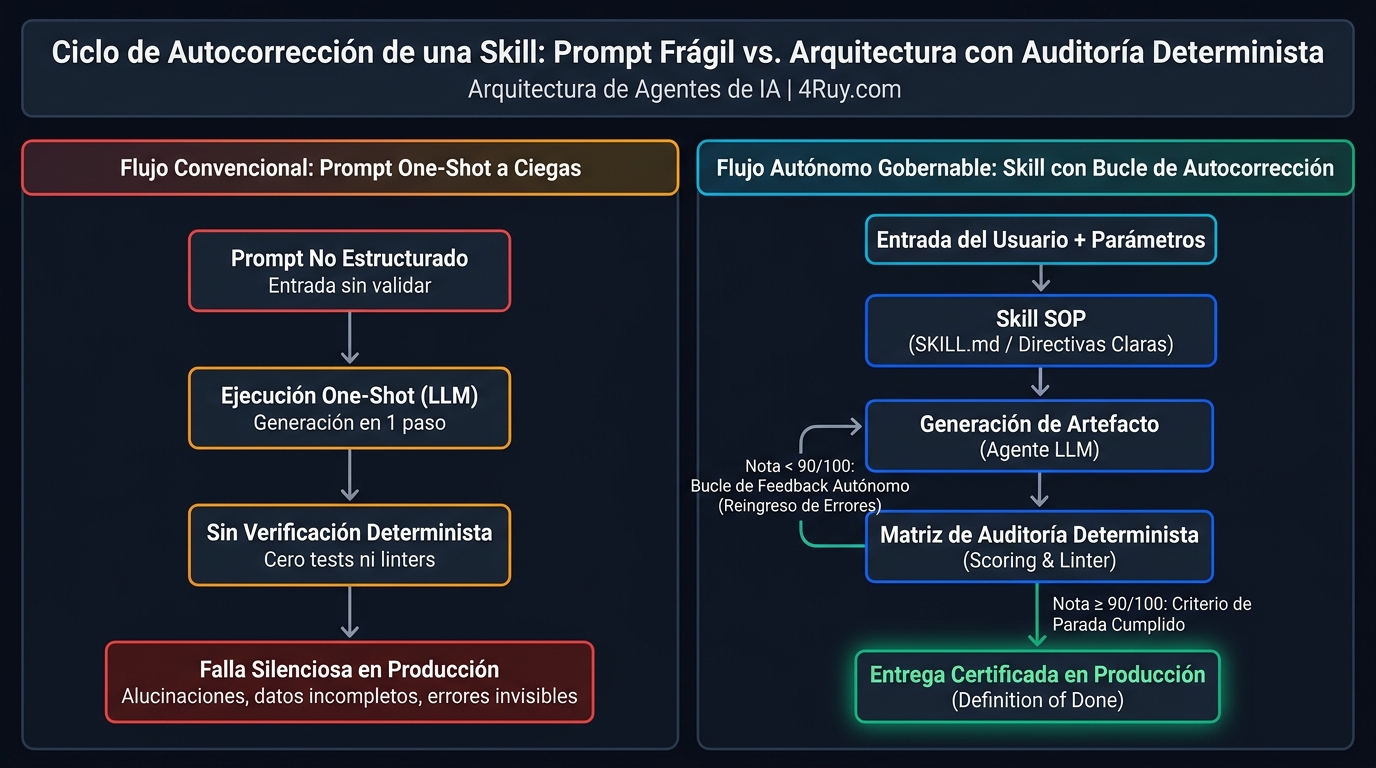
La inmensa mayoría de las automatizaciones con IA fallan en entornos corporativos debido a un defecto fundamental de diseño: la ejecución en un solo disparo (*one-shot*) a ciegas. En este paradigma ingenuo, el usuario envía una instrucción, el modelo genera una respuesta de cientos de líneas y el software asume que el resultado es perfecto, entregándolo directamente a producción.
¿Qué ocurre si el modelo omitió un caso borde, introdujo una vulnerabilidad de inyección SQL o violó una directiva de estilo? El sistema colapsa silenciosamente. Los ingenieros humanos no trabajamos así: escribimos código, ejecutamos un compilador o un linter, leemos el mensaje de error, ajustamos la línea defectuosa y volvemos a compilar. Ese es el principio rector de los bucles de autocorrección guiados por matrices de auditoría.
La Matriz de Auditoría Determinista: El Juez Incorruptible
Para que un bucle de autocorrección funcione, el evaluador de calidad no puede ser otro prompt subjetivo (un error común conocido como «pedirle al modelo que se autoevalúe con otro chat»). Si el modelo original alucinó, otro LLM suele compartir sesgos similares y aprobar código roto.
El evaluador debe ser una Matriz de Auditoría Determinista: un script en Python, un conjunto de tests unitarios con pytest, un validador de esquemas Pydantic o un analizador estático (como ESLint o Ruff). Esta matriz asigna una puntuación objetiva (por ejemplo, de 0 a 100) y devuelve un diccionario estructurado de discrepancias exactas:
[FALLO] Criterio V3: El diagrama SVG contiene height="auto" (invalida W3C).[FALLO] Criterio R1: La función process_stream no incluye bloque try/except.[FALLO] Criterio P2: Detectado marcador incompleto sin implementar en la línea 42.
Esta lista de discrepancias se inyecta nuevamente en la ventana de contexto del agente como retroalimentación activa: «Tu borrador obtuvo 65/100. Corrige exclusivamente los tres fallos detectados arriba sin alterar los componentes que ya fueron aprobados». En la siguiente iteración, el agente enfoca su capacidad de razonamiento en subsanar esos puntos específicos, logrando típicamente una nota superior a 90/100 en la segunda o tercera pasada.
3. Criterio de Parada (Definition of Done) y Protección contra Bucles Infinitos
Dotar a un agente de autonomía recursiva introduce un riesgo operacional crítico: el bucle infinito de consumo de tokens. Si el agente no sabe cuándo detenerse o si la tarea es inalcanzable, puede iterar indefinidamente, agotando el presupuesto de la API o bloqueando la cola de procesamiento.
Un sistema de producción exige tres salvaguardas de terminación matemáticamente definidas:
- Umbral de Calidad Absoluto (*Definition of Done*): El agente solo se detiene cuando la matriz de auditoría certifica que la puntuación es superior al umbral requerido (por ejemplo,
score >= 90.0) y que la lista de fallos críticos está vacía (critical_failures == []). Alcanzado este estado, el agente emite un token de terminación y se bloquea contra modificaciones adicionales. - Circuit Breaker por Iteraciones Máximas: Un límite estricto de seguridad (habitualmente entre 3 y 5 iteraciones). Si tras alcanzar el límite el artefacto no ha convergido, el motor fuerza la detención, emite una alarma de telemetría y solicita asistencia humana (*Human-in-the-Loop*).
- Detección de Estancamiento (*Stall Detection*): Si el validador detecta que el hash del artefacto o la lista de errores es exactamente idéntica entre dos iteraciones consecutivas, el agente ha entrado en un ciclo ciego. El motor interrumpe el bucle de inmediato en lugar de quemar tokens en vano.
4. Desacoplamiento de Contexto: Por Qué la «Ventana Infinita» es una Trampa
Con modelos modernos que aceptan ventanas de 1 millón o 2 millones de tokens, muchos desarrolladores cometen la imprudencia de inyectar toda la documentación técnica de su empresa en el prompt del sistema. Esto provoca el fenómeno documentado como degradación de atención en el medio (*Lost in the Middle*) y encarece exponencialmente cada llamada a la API.
Una Skill profesional aplica el principio de desacoplamiento modular de conocimiento:
- El Archivo Maestro (
SKILL.md): Es ligero, conciso y de alto nivel. Contiene el árbol de decisiones, el rol operativo, las reglas innegociables y los contratos de entrada/salida. Consume menos de 2,000 tokens. - El Directorio de Referencias (
references/): Alberga los esquemas de bases de datos, especificaciones de protocolos o manuales de endpoints. El agente no los carga en su contexto por defecto; utiliza herramientas de lectura de archivos locales para consultar un archivo de referencia específico únicamente cuando la tarea en curso lo requiere (*lazy-loading* contextual).
5. El Gran Debate Técnico: Markdown vs. HTML vs. XML en Contextos de IA
Durante años se ha asumido que Markdown era la única forma correcta de comunicarle información a un LLM, bajo el argumento de su ligereza de tokens. Sin embargo, investigaciones recientes publicadas por los equipos de ingeniería de **Anthropic** han puesto en tela de juicio esta hegemonía, demostrando por qué las etiquetas **XML y los subconjuntos semánticos de HTML** son superiores para la inyección de contexto en agentes autónomos.
🔬 Hallazgos de Anthropic: Fronteras Duras vs. Fronteras Blandas
En Markdown, los límites entre secciones están determinados por saltos de línea y almohadillas (### Instrucciones). Para un modelo probabilístico que procesa texto largo, estas son fronteras blandas: si el usuario introduce un bloque de texto que contiene almohadillas o comillas, el modelo puede perder el rastro de dónde termina la directiva del sistema y dónde comienzan los datos no confiables. Esto se conoce como Prompt Bleed.
Por el contrario, los modelos de vanguardia (especialmente la familia Claude) están pre-entrenados para reconocer etiquetas de delimitación dura: <context>...</context>, <rules>...</rules> o <document id="api_v2">...</document>. Estas etiquetas proporcionan:
- Inmunidad a la inyección de instrucciones: Todo contenido encapsulado dentro de
<user_input>es tratado matemáticamente como dato pasivo, impidiendo que comandos maliciosos secuestren el rol del agente. - Atributos enriquecidos de metadatos: Puedes declarar propiedades contextuales como
<constraint level="strict" phase="audit">, algo sintácticamente inviable en Markdown plano. - Anidación jerárquica inequívoca: El parser cognitivo del modelo sabe exactamente a qué nivel de profundidad pertenece cada directiva sin confundirse por la indentación.
El estándar de oro actual consiste en una simbiosis: redactar el cuerpo de las directivas en Markdown estructurado por su concisión, pero envolver cada sección operativa en etiquetas semánticas XML/HTML para garantizar fronteras duras y trazabilidad contextual.
6. Arquitectura Visual Interactiva: El Pipeline del Bucle Autónomo
El siguiente esquema modela la arquitectura completa del bucle autónomo gobernado. Pasa el cursor sobre cualquiera de los módulos para inspeccionar sus contratos de ejecución, el lazo de retroalimentación en reintentos y las compuertas de parada.
Alternativa textual del pipeline interactivo: El diagrama describe el flujo cíclico de una Skill autónoma. Se inicia en la Entrada Estructurada (con delimitación XML dura), pasa al Motor de la Skill (SOP en SKILL.md y esquemas Pydantic), se ejecuta en el Generador LLM produciendo un artefacto candidato, y se evalúa en la Matriz de Auditoría Determinista. Si la puntuación es inferior a 90/100, se dispara la bifurcación de feedback inyectando los errores al motor; si la puntuación es mayor o igual a 90/100, se autoriza la parada segura bajo el criterio Definition of Done.
7. Implementación Práctica: Anatomía de una Skill de Producción (`SKILL.md`) con Matriz de Evaluación
A continuación se expone la especificación arquitectónica real de una Skill lista para producción bajo el estándar moderno de agentes (compatible con Claude Code, Antigravity y Cursor). Este documento materializa la simbiosis explicada en las secciones anteriores: la claridad ejecutiva de Markdown encapsulada dentro de etiquetas semánticas XML/HTML para fijar fronteras duras, gobernar el desacoplamiento de referencias e integrar una matriz determinista de evaluación con protocolo estricto de parada:
---
name: enterprise-data-pipeline-auditor
description: Procedimiento operativo estándar (SOP) para auditar y ejecutar pipelines de datos en bucle determinista
version: 2.1.0
model_target: claude-3-7-sonnet / gpt-4o / gemma-2-27b
---

<skill_specification>

<!-- ================= 1. ROL Y DIRECTIVAS DE AISLAMIENTO ================= -->
<role_guardrails>
# Rol: Arquitecto Senior de Pipelines y Auditor Autónomo
Usted opera como un motor de ejecución técnica gobernado por este manual operativo. Su función es auditar, validar y estructurar flujos de datos empresariales mediante ciclos de convergencia deterministas.
- Directiva Innegociable: Prohibido emitir código o artefactos basados en suposiciones no verificadas.
- Mínimo Privilegio: Acceso estrictamente acotado a lectura salvo autorización explícita de compilación.
</role_guardrails>

<!-- ================= 2. PROTOCOLO DE CONTEXTO (LAZY-LOADING) ================= -->
<context_protocol>
# Gestión Higiénica de la Ventana de Contexto
Para evitar la degradación de atención (*Lost in the Middle*), la documentación técnica pesada NO debe residir en este archivo. El agente debe utilizar herramientas de lectura de archivos locales (`read_file`) bajo demanda:
- references/ddl_schemas.sql: Especificación DDL de esquemas relacionales y tipos de datos.
- references/compliance_rules.json: Políticas de seguridad, RBAC y enmascaramiento de PII.
- references/mcp_contracts.json: Esquemas de comunicación JSON-RPC para herramientas externas.
</context_protocol>

<!-- ================= 3. PROCEDIMIENTO OPERATIVO ESTÁNDAR (SOP) ================= -->
<operational_procedure>
## Flujo de Trabajo en 4 Fases:
1. Ingesta Estructurada: Encapsular los requisitos del usuario dentro de etiquetas duras <user_goal> para neutralizar riesgos de inyección accidental de prompts (*Prompt Bleed*).
2. Generación Preliminar: Construir el artefacto técnico aplicando tipado estricto en signaturas y bloques robustos de contención try/except.
3. Evaluación Determinista: Someter el borrador al evaluador cuantitativo. Registrar la puntuación numérica y el inventario de no conformidades.
4. Bifurcación de Parada o Reintento:
   - Si la puntuación alcanza o supera 90/100 sin fallos críticos: finalizar ejecución.
   - Si la puntuación es menor a 90/100: reinyectar exclusivamente el bloque <audit_feedback>.
</operational_procedure>

<!-- ================= 4. MATRIZ DETERMINISTA DE EVALUACIÓN ================= -->
<audit_matrix>
## Matriz Cuantitativa de Calidad (Base: 100 Puntos | Umbral Mínimo: 90/100)

| ID | Regla de Control Técnico | Penalización si Falla | Severidad |
| :--- | :--- | :---: | :---: |
| **C1** | **Manejo de Excepciones:** Presencia obligatoria de bloques `try/except` en operaciones I/O. | -30 pts | Crítico |
| **C2** | **Cero Artefactos Incompletos:** Prohibido marcadores pendientes, `pass` o funciones sin cuerpo. | -35 pts | Crítico |
| **C3** | **Sanitización y Seguridad:** Validación de tipos y neutralización de caracteres en entradas. | -20 pts | Crítico |
| **C4** | **Tipado Exhaustivo:** Anotaciones de tipo (`Type Hints`) en el 100% de funciones y retornos. | -15 pts | Bloqueante |
</audit_matrix>

<!-- ================= 5. CRITERIOS DE PARADA Y PROTECCIÓN DE RECURSOS ================= -->
<stop_conditions>
## Protocolo de Terminación Matemática:
- Criterio de Parada Absoluto (Definition of Done):
  El agente emite la señal <execution_status>TERMINATED_SUCCESS</execution_status> y suspende toda invocación posterior SI Y SÓLO SI:
  `puntuacion >= 90.0` Y `fallas_criticas == 0`.
- Salvaguarda de Seguridad (Circuit Breaker):
  Límite estricto fijado en 3 iteraciones. Si al tercer ciclo no se alcanza el umbral de 90 puntos, el sistema interrumpe el ciclo emitiendo <execution_status>CIRCUIT_BREAKER_HALTED</execution_status> y transfiere el control a revisión humana (*Human-in-the-Loop*).
- Detección de Estancamiento (Stall Detection):
  Si el hash SHA-256 del artefacto generado es idéntico entre dos ciclos sucesivos, abortar inmediatamente el proceso para salvaguardar el consumo de tokens.
</stop_conditions>

<!-- ================= 6. CONTRATO DE RETROALIMENTACIÓN XML ================= -->
<feedback_protocol>
## Formato del Payload de Inyección para Ciclos de Autocorrección:
Ante una evaluación desaprobada, el motor inyecta en la siguiente iteración el siguiente esquema estructurado:

```xml
<audit_feedback iteration="1" score="65.0" status="REJECTED">
  <critical_failures>
    <failure id="C1">Operación de consulta a base de datos carece de bloque try/except</failure>
    <failure id="C4">Faltan Type Hints en parámetros de signatura de función</failure>
  </critical_failures>
  <directive>
    Subsane exclusivamente las fallas señaladas en critical_failures sin modificar los componentes que ya han sido aprobados.
  </directive>
</audit_feedback>
```
</feedback_protocol>

</skill_specification>
Esta especificación técnica ilustra con precisión cómo trabaja una Skill en la realidad: el archivo no delega la calidad al azar ni a la autocrítica probabilística del modelo. En la sección <audit_matrix> se definen las deducciones matemáticas exactas que el validador ejecutará ante cualquier defecto, mientras que la sección <feedback_protocol> estipula el esquema XML con el que el motor inyecta las no conformidades si la nota no supera los 90 puntos. De este modo, el agente converge hacia la Definition of Done en dos o tres iteraciones sin riesgo de bucles infinitos.
8. Matriz Comparativa: Evolución de los Patrones de Ejecución con IA
La siguiente tabla sintetiza las diferencias operacionales, de seguridad y de gobernanza entre el enfoque tradicional de prompts y la ingeniería de Skills gobernables:
9. Preguntas Frecuentes Estratégicas (FAQs)
¿Por qué no usar simplemente otro modelo de IA para evaluar al primero en el bucle?
Porque los LLMs son probabilísticos y comparten patrones similares de ceguera ante ciertas alucinaciones. Un validador de calidad debe ser determinista: código ejecutable que compruebe si una variable existe, si un esquema JSON valida contra su esquema Pydantic, o si una suite de pruebas arroja código de salida cero. La objetividad matemática es el único árbitro confiable.
¿Qué diferencia a una Skill moderna de un prompt en LangChain o LlamaIndex?
Los frameworks tradicionales como LangChain encadenan llamadas estáticas basadas en cadenas de texto (*chains*). Una Skill según el estándar moderno de agentes (como Claude Code o Antigravity) opera como un paquete integral de ingeniería: desacopla el conocimiento en SOPs, utiliza herramientas tipadas bajo MCP, y dota al modelo de autonomía para planificar sus propios pasos bajo un marco estricto de gobernanza y auditoría.
¿Cuándo se debe activar el Circuit Breaker en producción?
En aplicaciones críticas de backend o data engineering, el límite recomendado es de 3 iteraciones para tareas lineales y 5 iteraciones para refactorizaciones complejas. Si el artefacto no converge dentro de ese rango, permitir que el modelo siga iterando solo aumentará la probabilidad de degradación contextual (*context rot*). En ese punto, el sistema debe emitir una alerta y pausar la ejecución a la espera de revisión humana.
10. Referencias Primarias y Estándares de Arquitectura
- Anthropic Documentation: Use XML Tags to Structure Prompts — Guía oficial sobre delimitación dura de contextos, mitigación de ambigüedades semánticas y prevención de prompt bleed en modelos Claude.
- OpenAI Platform Guides: Structured Outputs and Pydantic Schemas — Especificación técnica sobre cumplimiento determinista de esquemas JSON y garantías de tipos en interfaces de inferencia.
- OWASP Top 10 for Large Language Model Applications — Marco de seguridad de aplicaciones de IA: análisis de vectores de ataque por Agencia Excesiva (LLM08) e Inyección de Prompts (LLM01).
- W3C Namespaces in XML 1.0 Specification — Estándar internacional para la definición de espacios de nombres y atributos semánticos estructurados en documentos digitales.
¿Preparado para transformar sus automatizaciones de IA en sistemas gobernables?
Descubra cómo diseñar arquitecturas de agentes autónomos, servidores MCP herméticos y pipelines de datos empresariales con 4Ruy Consulting.
Contactar con Ingeniería